正式开源|我们把“可验证”写进了大模型的训练目标——LabOpen v1 发布
每个做过科研的人,大概都经历过这样的时刻:
问 AI 一个专业问题,它回答得流畅、漂亮、体面——但你不敢引用。因为“看起来对”和“可以被验证”,是两回事。
这是华曼生物科技(北京)有限公司人工智能实验室(Hooman AI Lab)、国声智库人工智能研究中心做LabOpen v1 的起点。我们不想做更大的模型,只想回答一个朴素的问题:大模型的科研回答,能不能做到逐条可验证?
一组先亮出来的数字
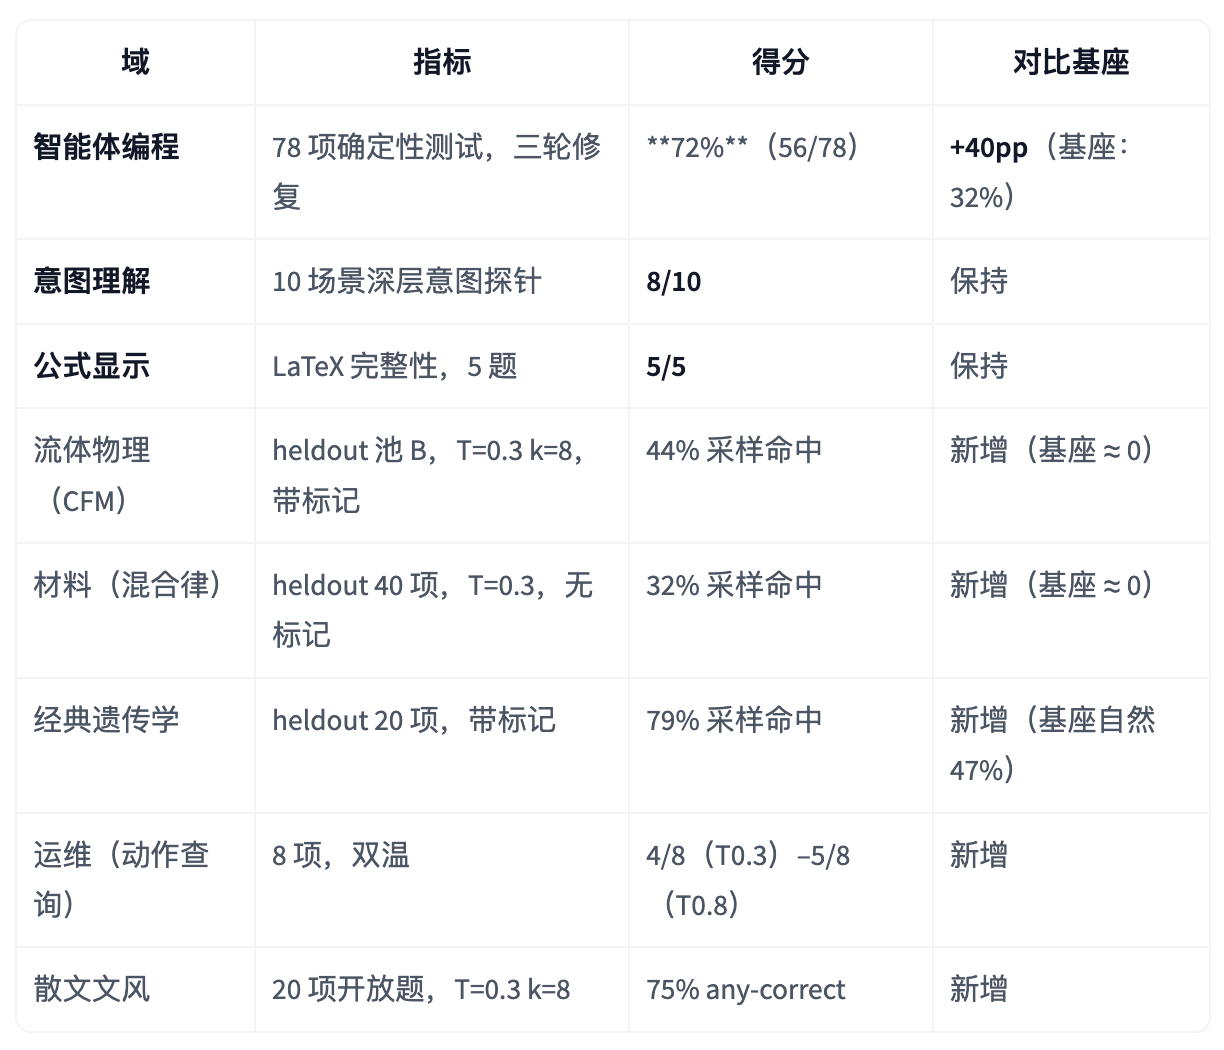
基于开源原版模型 Qwen3.8-27B,经过大量实验与后训练强化学习工程设计,LabOpen v1 在封存答案的盲测中交出了这样的成绩单:
· 编程能力:78 项标准化任务中,模型要像工程助手一样自己写码、跑测试、改错误,通过率从原版的 32% 提升到 72%;
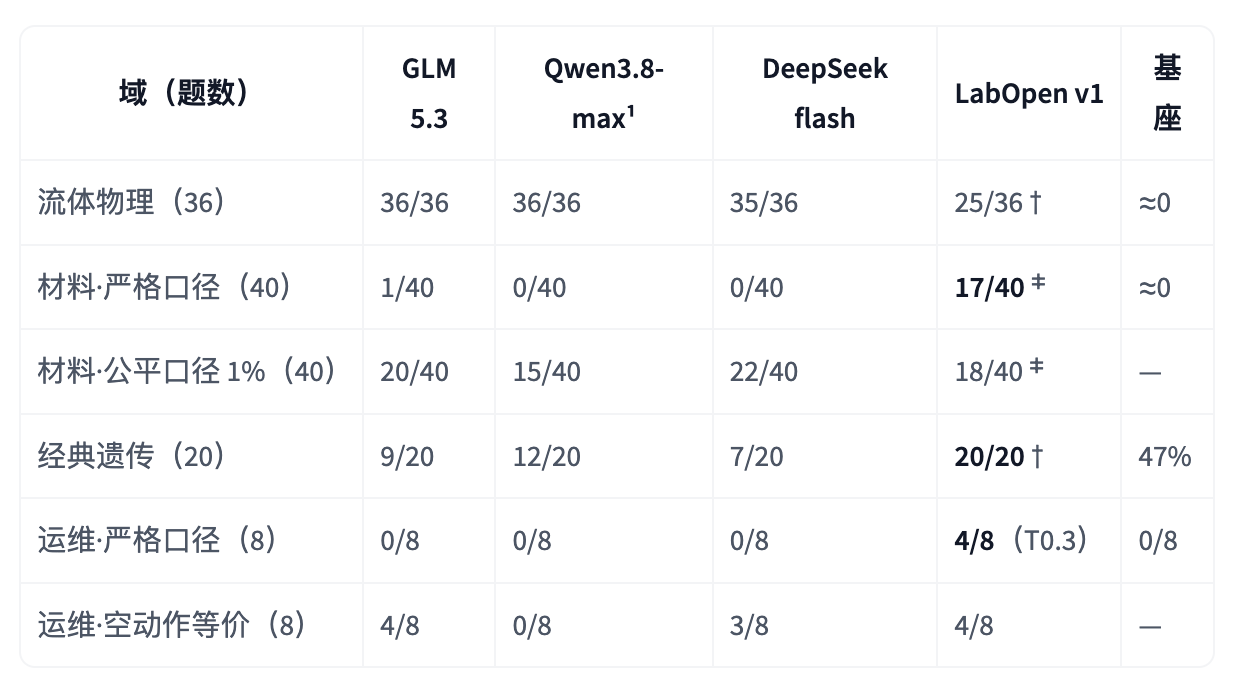
· 经典遗传学:满分 20 题 20 对——同期对照的几款国际前沿大模型,在不做任何专门调优的情况下只有35% 到 60%;
· 材料物性:对材料属性表的精确复现能力为 42%,参测前沿模型全部不足 3%;
· 同时,原版模型已有的代码生成、函数调用、意图理解、公式显示,一项没丢。
也有我们还没赢的地方:流体物理的链式计算上,前沿模型目前更强。这条也如实写在了开源模型卡里。因为我们相信,能被验证的回答才是科研能用的回答——包括验证我们自己。
我们是怎么做的
不堆参数,不追热点。实验室用一套朴素的强化学习方法:奖励不靠人工打分,全部由程序按预设规则逐条判分——答案算对就是算对,算错就是算错,截断、格式错误、运行出错各自单独记过。六个能力方向(流体物理、材料混合律、遗传学、运维操作、编程、学术表达)逐个训练、逐个闯“盲测关”:题目提前锁定、答案绝不参与训练,过不了关,这一轮的训练方案就作废。发布之前,最终成品还与训练原版做了逐字比对——生成的每一个字都一致,才准出门。
完全开源,本地可部署
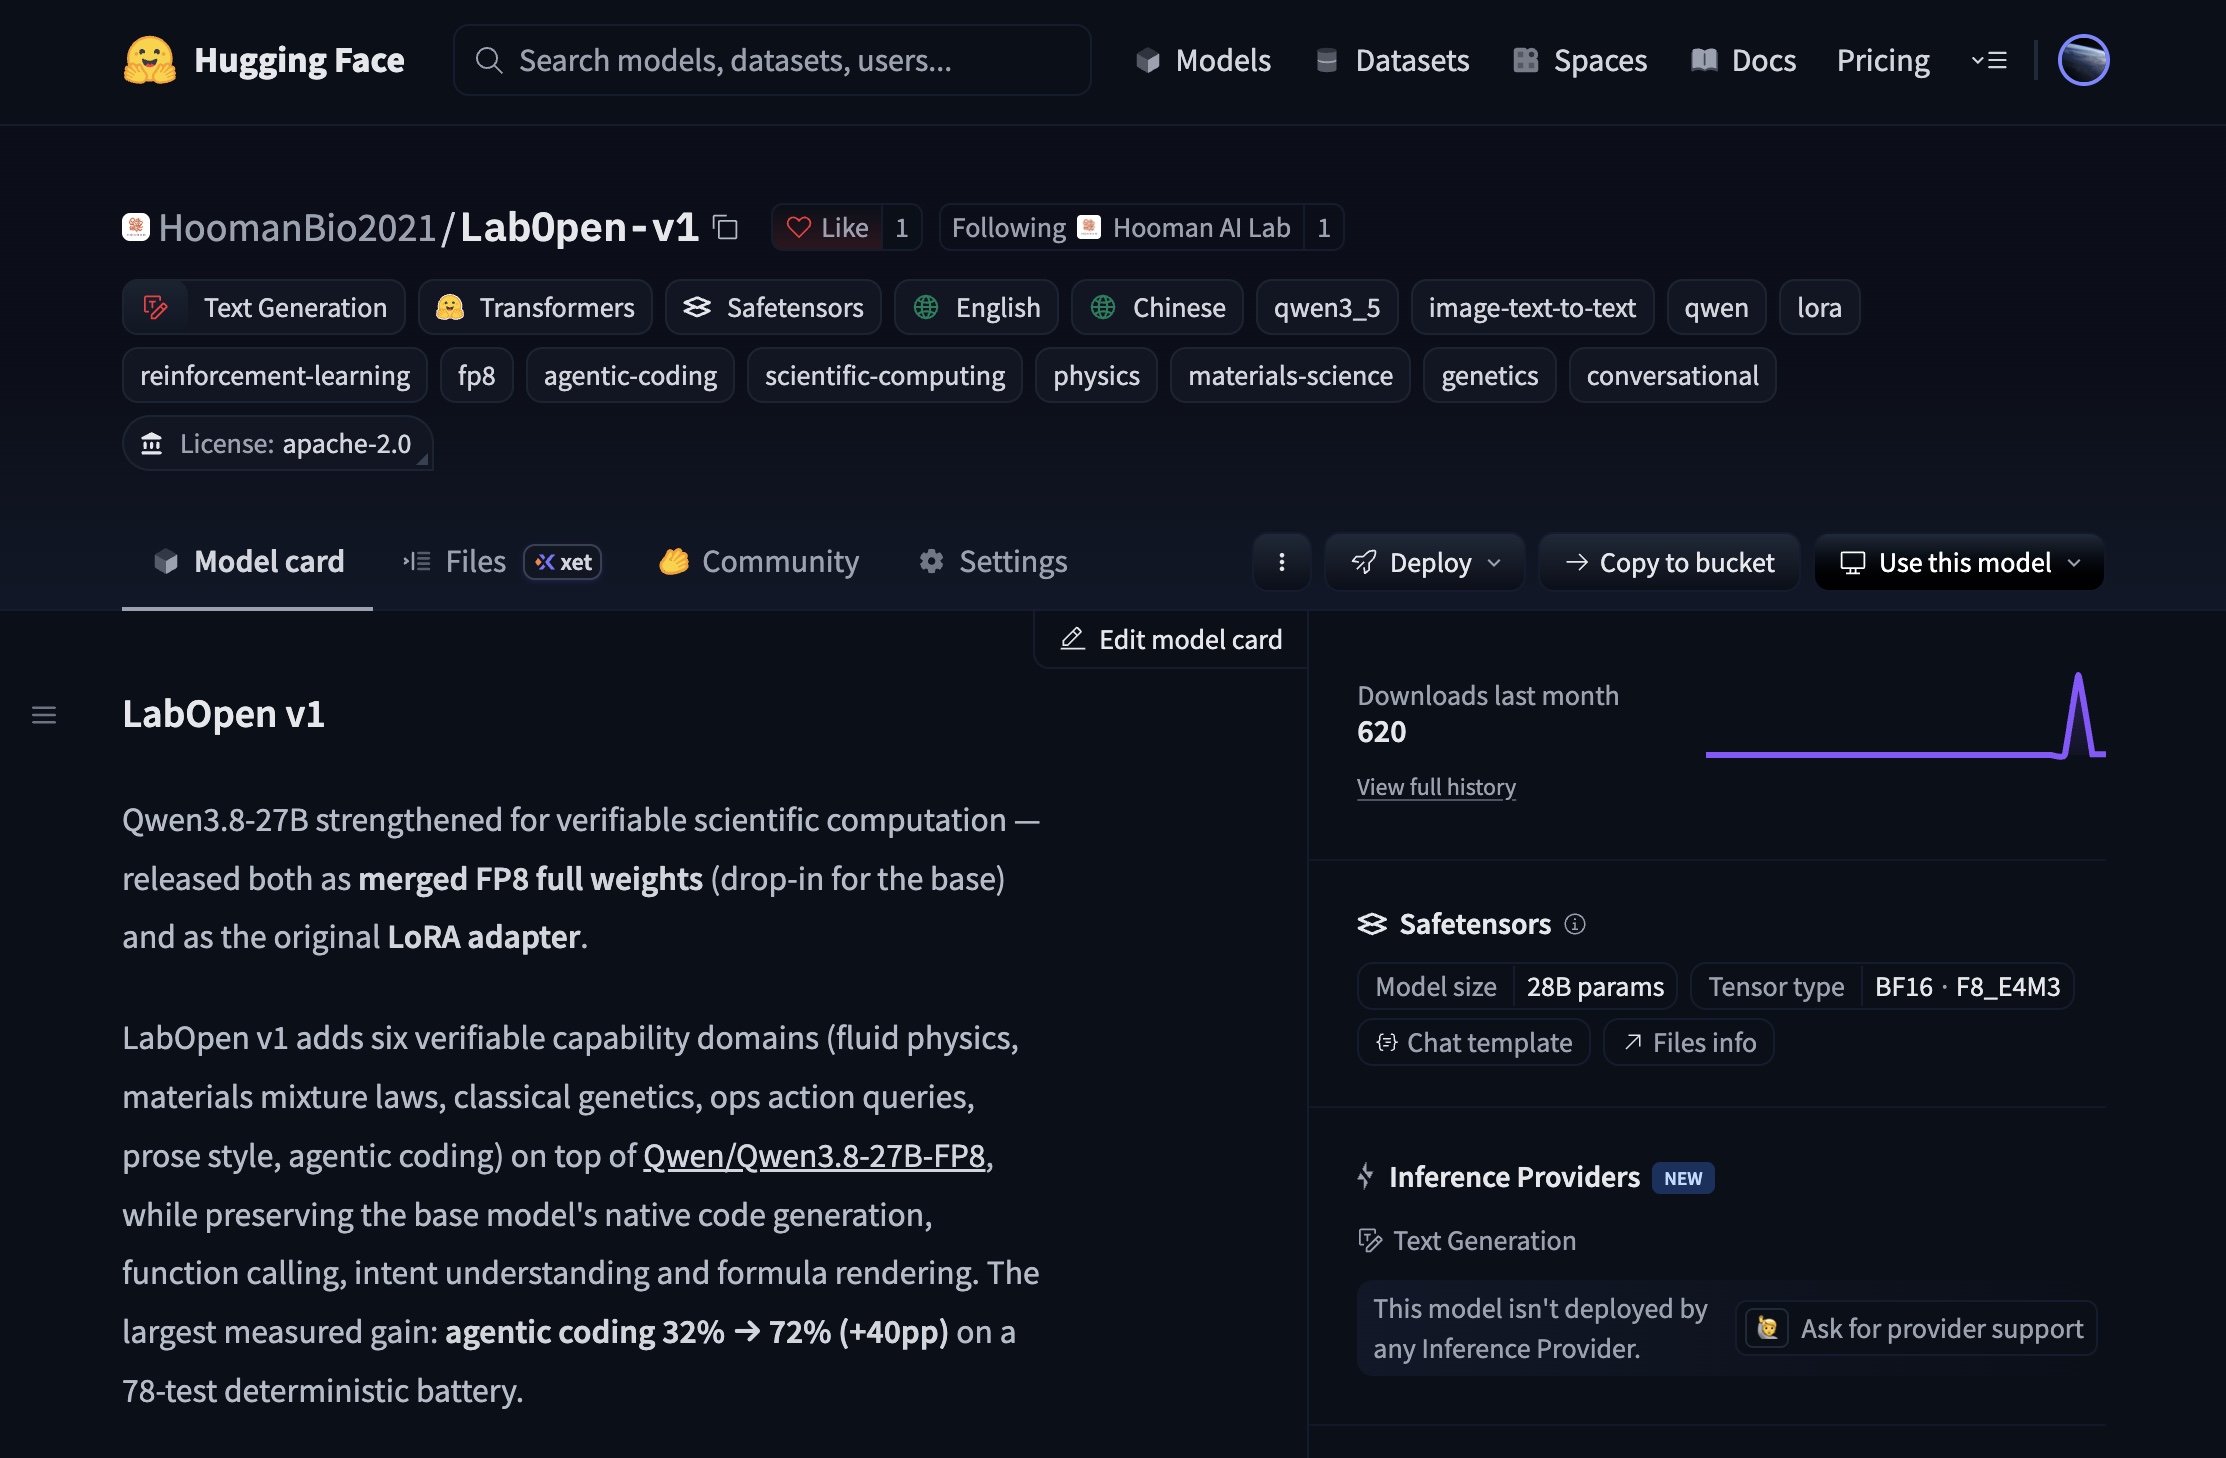
LabOpen v1 采用业界最宽松的 Apache 2.0 开源协议,免费可商用。提供两种下载形态:即用版完整模型(FP8 高效格式,约 31GB,体积比常规精度减半)与轻量训练留档(112MB)。一张较新一代的支持 FP8 的显卡(如NVIDIA H100、DGX GB10)即可本地私有化部署——科研数据不出实验室。
一个邀请
无论你是高校课题组、科研院所,还是企业研发团队,都欢迎下载试用、反馈真实场景的问题。模型卡里有全部评测口径与能力边界,欢迎监督,欢迎交流。
开源地址: https://huggingface.co/HoomanBio2021/LabOpen-v1
联系我们: service@hoomanbio.com
—— 华曼生物人工智能实验室(Hooman AI Lab)
相关链接
阅读原文