把“可验证”训练进模型——LabOpen v1 的能力与技术全景
大语言模型进入科研工具箱的真正障碍,从来不是它不够聪明,而是它不够可信。一个流畅、体面、看起来无懈可击的回答,科研人却不敢直接引用——因为“看起来对”与“可以被验证”之间,隔着一条宽得惊人的鸿沟。华曼生物人工智能实验室、国声智库人工智能研究中心这次开源的LabOpen v1,就是想用一整套训练与工程方法,把这条鸿沟填掉一部分:让模型在强化域里给出的每一个答案,都能被程序逐条校验;让“可信”不再是一句承诺,而是训练目标本身。
先说结论,再说来路
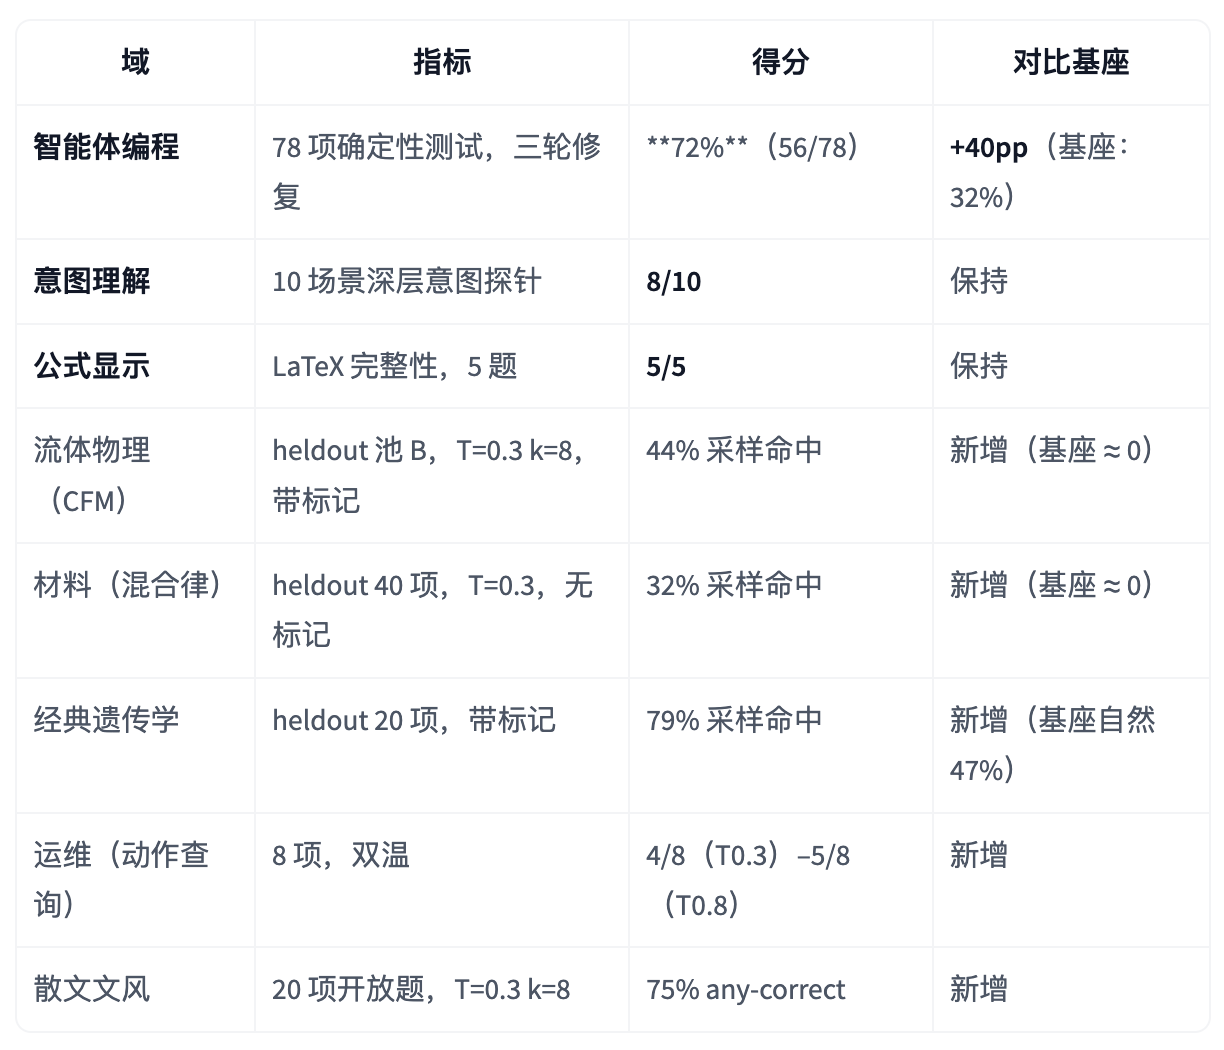
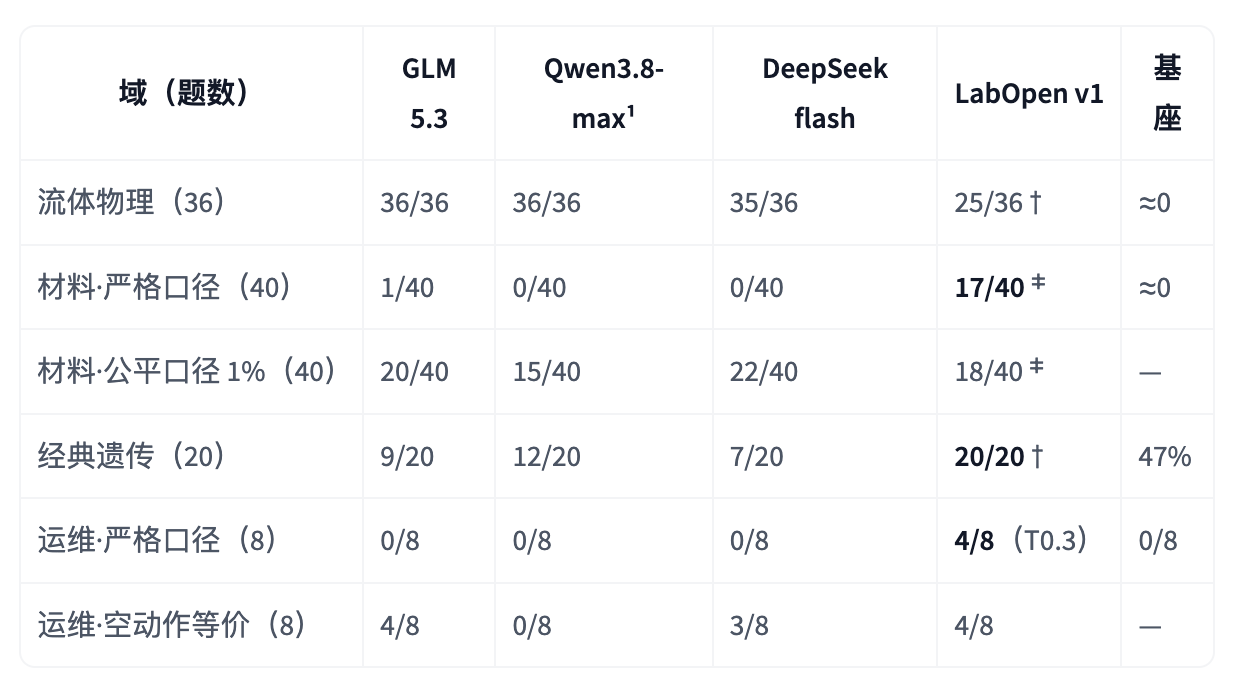
LabOpen v1 基于开源模型 Qwen3.8-27B,经过后训练强化学习来增强模型在科学研究场景中的的实操能力。在 78 项标准化自主编程任务(模型需自行写码、运行、修复)中,通过率从原版的 32% 推到 72%;在经典遗传学的盲测里拿到95分以上的成绩——题库提前封存、标准答案绝不参与训练,模型每题至少答对一次,二十题全中;同期对照的前沿大模型在不做任何专门调优的情况下只有 35% 到 60%。材料属性表的精确复现能力为 42%,参测前沿模型全部落在 3% 以内。而在流体物理的链式计算上,前沿模型依然全面领先于我们。这条我们也如实写进了开源模型卡。实验室的方法论就一句话:测量优先,胜负都公布。
这次发布包含两种形态:一套即用版完整权重——把训练成果直接并入原模型、经与训练原版逐字比对验证后放行(FP8 高效格式,约 31GB),和一份 112MB 的轻量训练留档(适配器原件,供研究与复现)。Apache 2.0 协议,免费可商用,地址在文末。
六个能力方向,与一种训练哲学
模型的能力不是撒网撒出来的。实验室为它定义了六个可验证能力方向:流体物理的链式计算、材料混合律、经典遗传学、运维操作判断、自主编程,以及学术表达。每个方向的训练数据都被构造成“条件可程序判分”的任务——答案要么算得对,要么算不对,没有中间态给模型留“体面”。
训练方法是组相对强化学习:每道题采样八次,组内比出优劣,优势信号回传。奖励完全来自程序校验,切断了一切“答案像不像对的”这类模糊信号。零起点的方向先用标准答案示范点火——把正确解法显式喂给模型,再让它与自己的采样同台竞争;已经领先的能力则请历代最强版本当“老师”,把已验证的正确解法示范给它;同时在每轮课程里保留旧能力的锚点题,防止“学会新的、忘掉旧的”这种跷跷板。多步任务则把奖励细化到推理过程的每一步——哪一步贡献了正确答案,哪一步得到强化。这一整套循环跑了十五轮,每一轮都要闯一道预注册的盲测关:题目与通过标准提前锁定,过不了关,这一轮的训练方案就作废。我们花了大量工程在“如何可信地知道一次训练有没有用”上,这可能与训练本身同样重要。
值得一提的还有思考行为的治理。基座模型在陌生题目上曾出现严重的“思考枯竭”——思考到一半就被长度上限掐断,最严重时材料方向近半数生成(320 次中 155 次)不完整。我们把截断、格式错误、运行异常设为相互独立的奖励类别,让模型显式学会“终止”这个动作。单个训练窗口内,被掐断的生成从 155/320 降到 0/320,单题生成时长从 327 秒降到 74 秒。治理之后,四个方向的思考不完整率均为零。
适配器很小,合并的门很大
训练本身只动了一小块低秩适配参数(rank-4 LoRA,992 张小矩阵、共 112MB,参数量不足全模型的千分之四),却覆盖了基座混合架构(48 层线性注意力加 16 层全注意力)的十二类投影。但把这点增量安全地“焊”进FP8 权重,是整个发布里最凶险的一段工程。
基座的权重以分块 FP8(高效 8 位数值格式)存储:每 128×128 的权重块共享一个缩放因子。直接调用常见的PEFT 合并工具,会把高精度增量加在 8 位码字上——静默损坏,且用户毫无感知。正确的做法是逐块还原为全精度、加上训练增量、再按块重新量化。我们这样做了,然后设了两道门:合并后的模型与训练原版做贪心生成逐字比对;写入磁盘重新加载后,再比对一次。第二道门——也就是用户真正下载到的那份文件——144 个生成字符全部一致,才算放行。平均重量化误差 0.33%,与原版自身 FP8 存储噪声同一量级。全部细节连同每个分件的校验指纹,一起写在开源项目仓库的 MERGE_REPORT.md 里。
顺带一个诚实的提醒:那份 112MB 的适配器是研究留档,不是服务路径。原生 Transformers 加载不了分块 FP8 基座,而 vLLM 的 LoRA 内核尚未覆盖混合线性注意力的投影模块——直接挂载会静默漏掉十二类中的五类。要服务,请用合并权重。
部署:一张 FP8 卡,四个参数
部署门槛我们用实机趟过:开源推理引擎 vLLM(0.27.1 版),任何较新一代的 NVIDIA 显卡(H100、L40S、B200、DGX GB10 均可,我们在 DGX GB10 上完成全部验证;A100 及更早架构不支持 FP8),单卡 48GB 显存起步、80GB 从容,权重共约 31GB。一条 vllm serve 命令即可拉起服务。
使用上有两个关键参数。其一是长度预算:模型先思考后作答,请求的输出上限要给到 4096 字符以上,否则思考链会吃光预算——1024 只会换来一段“思考到一半被截断、正文为空”的沉默。其二是方向标记:六个强化方向靠提示首行的一行标记寻址,如 [domain: bio-genetics];不加标记则回落到原版行为,代码与函数调用本就无需标记。采样温度建议 0.3(让选择既不固执也不发散)——多次评测发现,正确答案常不在最“顺口”的那个版本里。
边界,与下一步
这不是一次“战胜前沿”的发布。流体物理方向我们落后于通用前沿模型,材料方向在工程容差下与前沿持平,遗传与运维则是前沿模型调优前尚未覆盖的独特能力。单种子、单次训练,波动范围未完全表征——这些都写在模型卡的诚实边界一节。我们更愿意把它定义为一次方法论的公开,以及一套让每个结论都可复核的测量纪律。
下一步,实验室会沿三条线推进:扩大可验证能力方向的覆盖,深化多步组合推理的逐步奖励,以及把“可验证”从离线评测推进到在线服务。开源的意义不只是给出权重,更是给出可以被检验、被复用、被超越的方法。
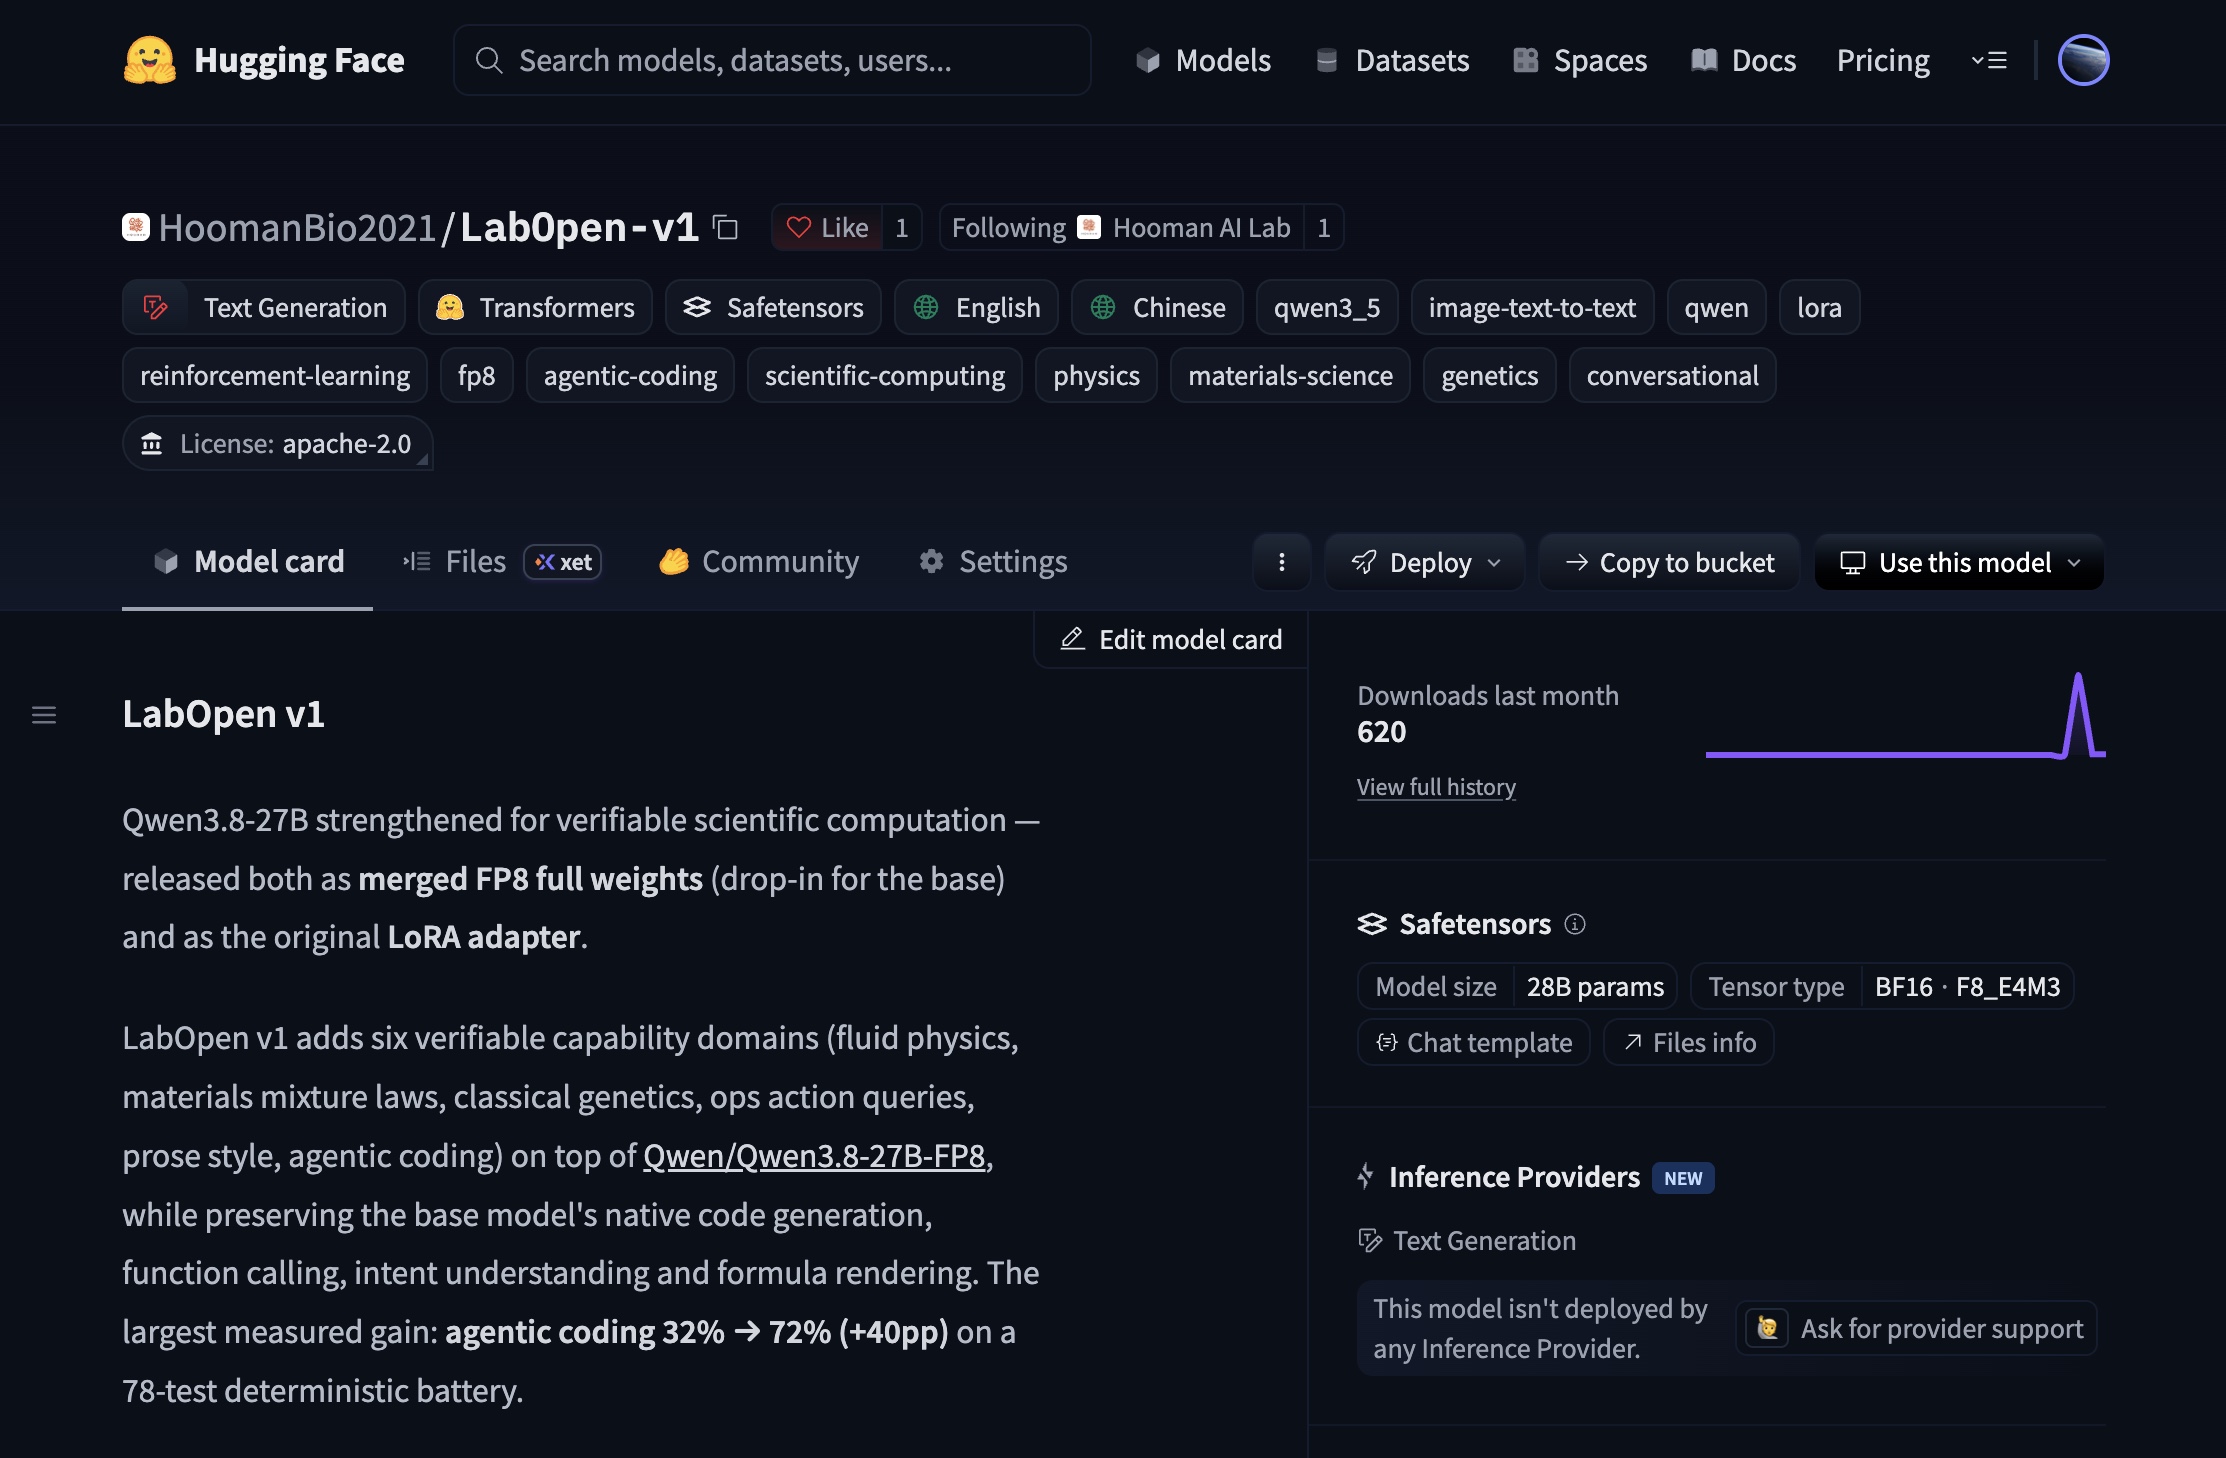
开源地址:https://huggingface.co/HoomanBio2021/LabOpen-v1
相关链接
阅读原文